Backend.AI 같은 서비스 제작하기: GPU 세션·팀별 자원 배정·모델 서빙 제작법
GPU 실행 세션과 팀별 할당량, 사용량 확인과 모델 배포를 연결하는 AI 인프라 운영 플랫폼의 구현 방법을 설명합니다.
핵심 요약
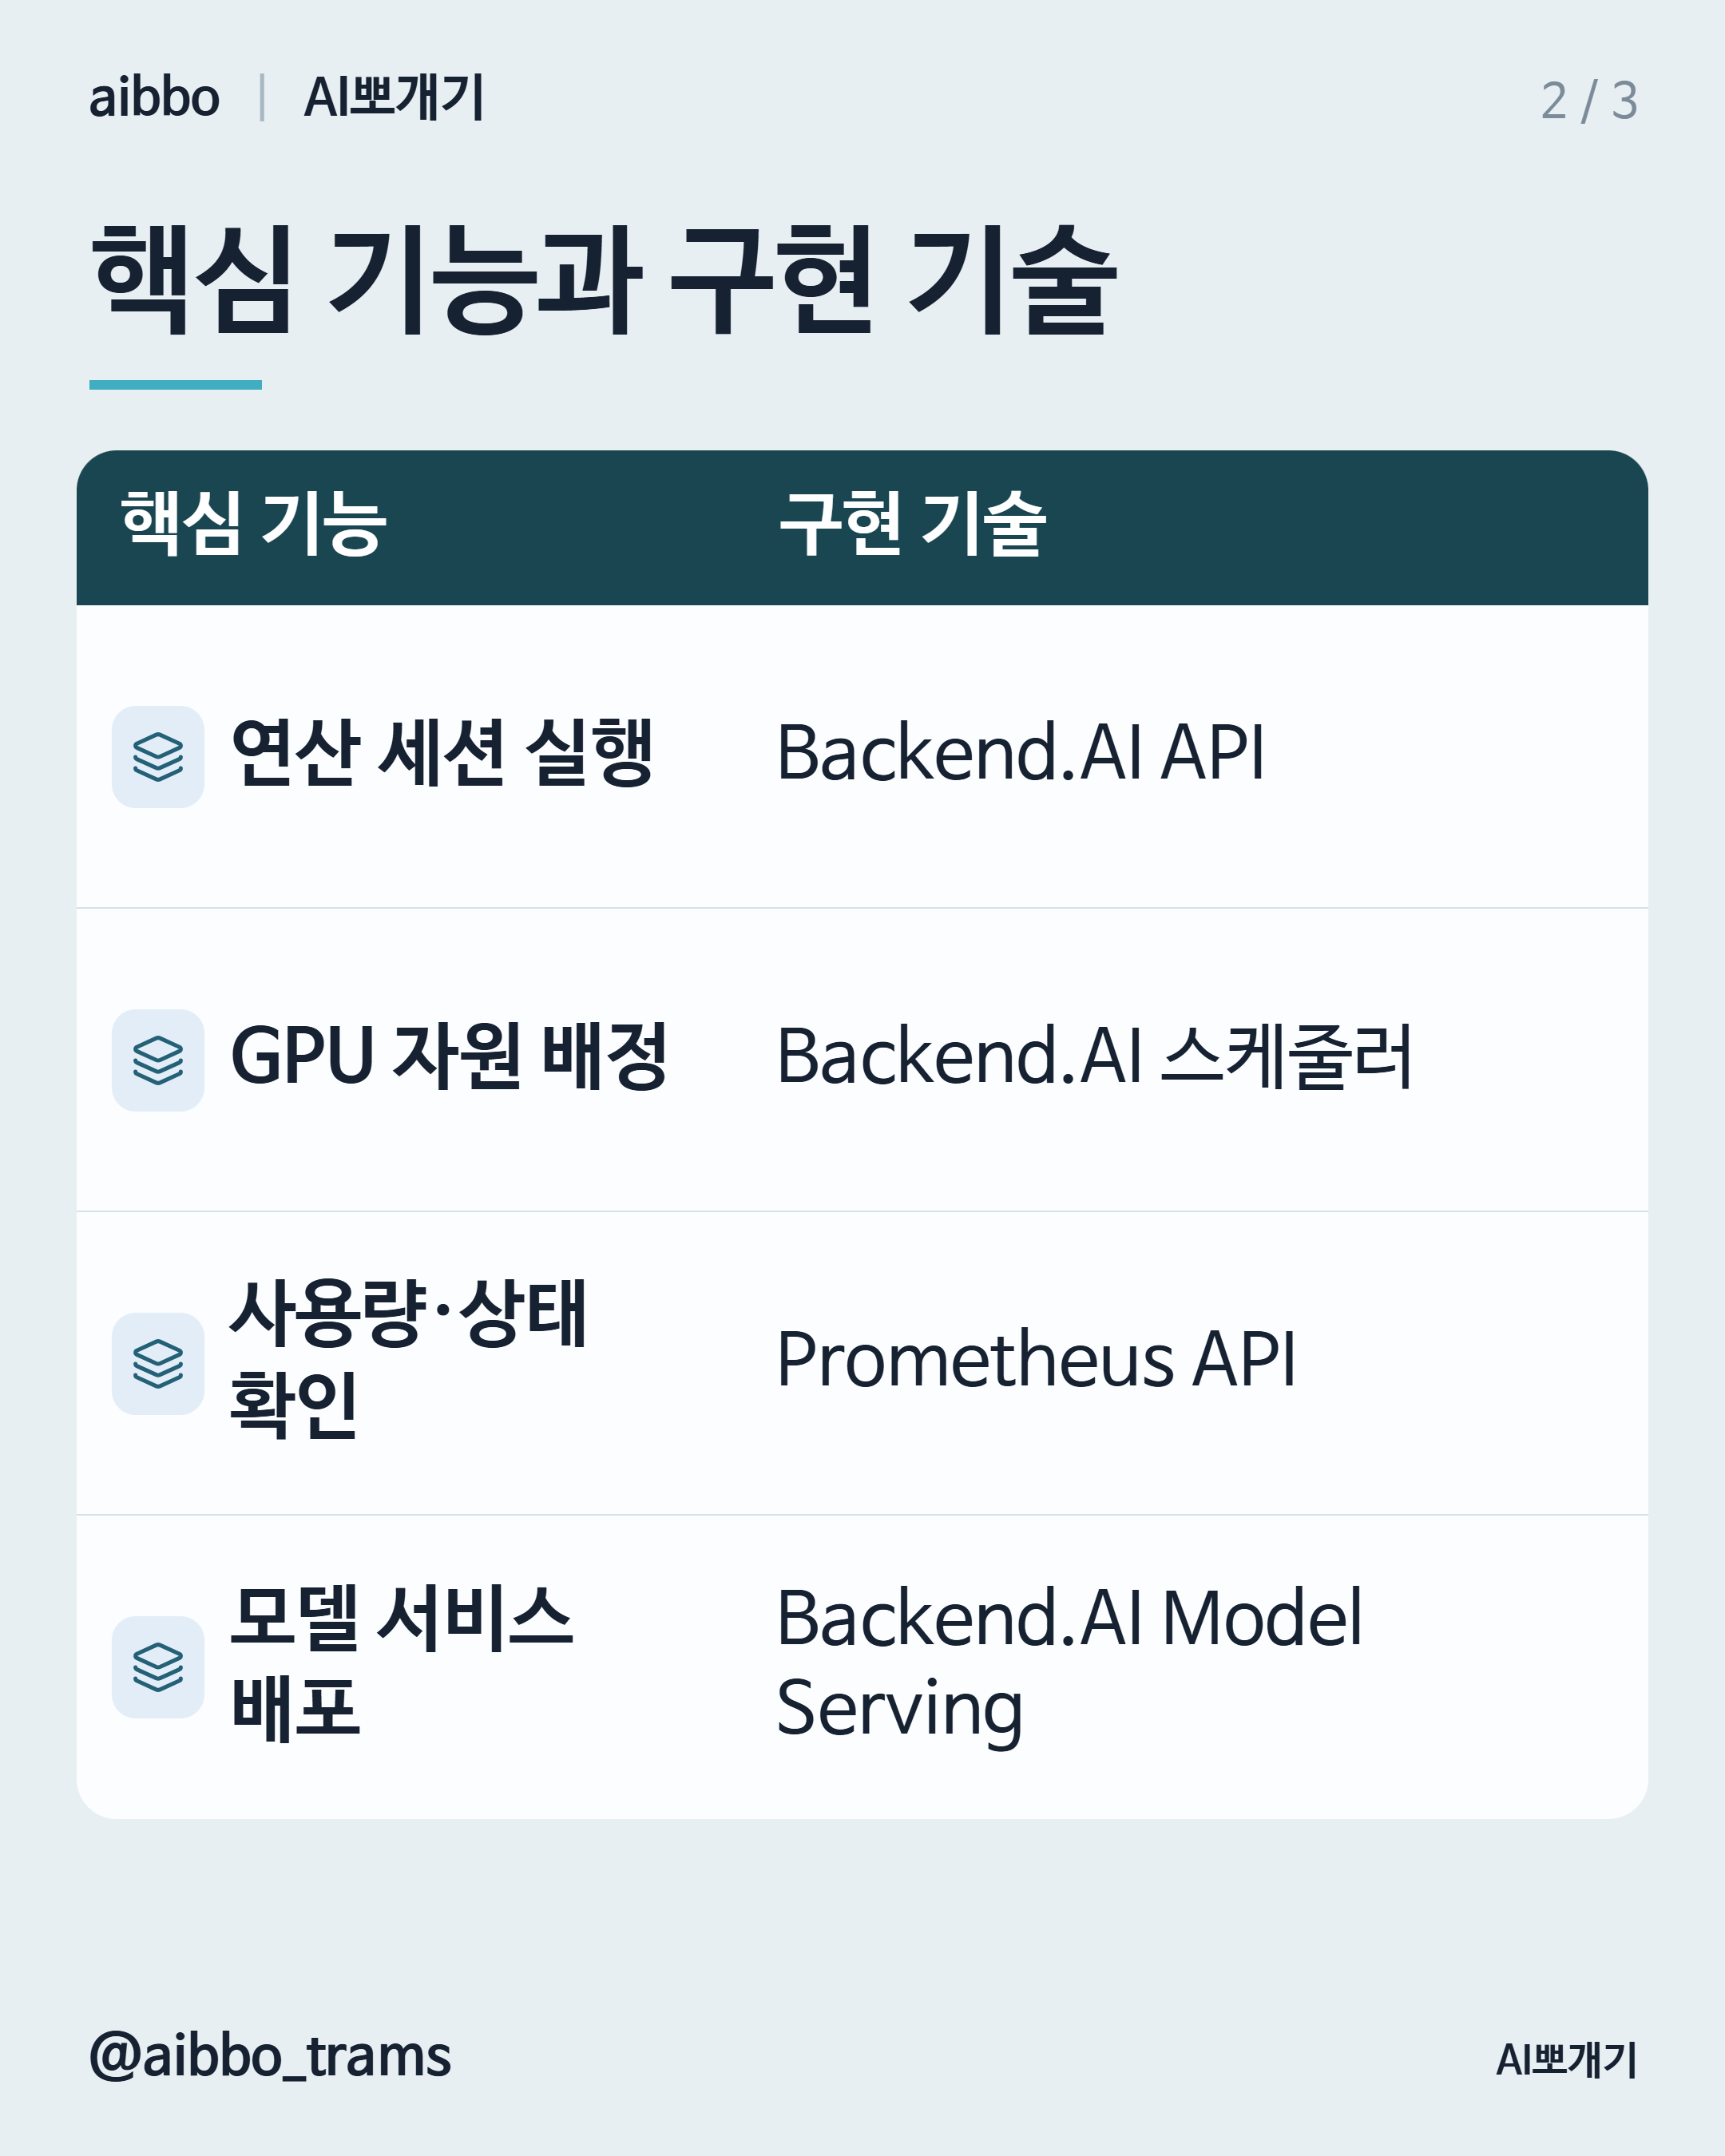
1. 사용자별 AI 실행 세션을 만들고 GPU 배정·사용량·모델 서빙을 연결하는 운영 플랫폼을 구성합니다. 2. Backend.AI API·스케줄러·Model Serving과 Prometheus API를 구현 후보로 활용합니다. 3. 클러스터 준비, 팀별 권한과 할당 정책, 세션 상태·비용·배포 검증은 별도로 설계합니다.
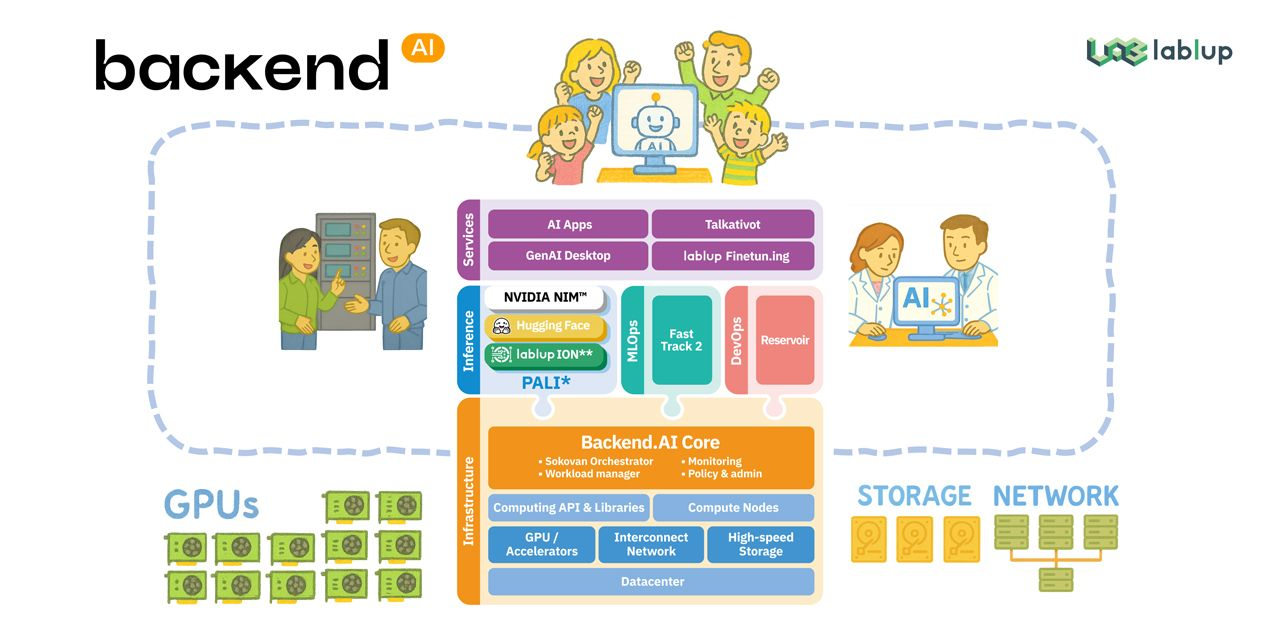
Backend.AI의 기능에서 참고할 가치는 여러 사용자가 AI 연산 자원을 함께 사용하는 환경을 관리하는 것입니다. GPU 관리 플랫폼 개발은 API 호출 화면 외에도 실제 서버와 GPU, 저장 공간과 네트워크가 준비돼야 합니다. 아래는 이 기반을 연결하는 구성입니다.
실행할 환경과 자원 요청 받기
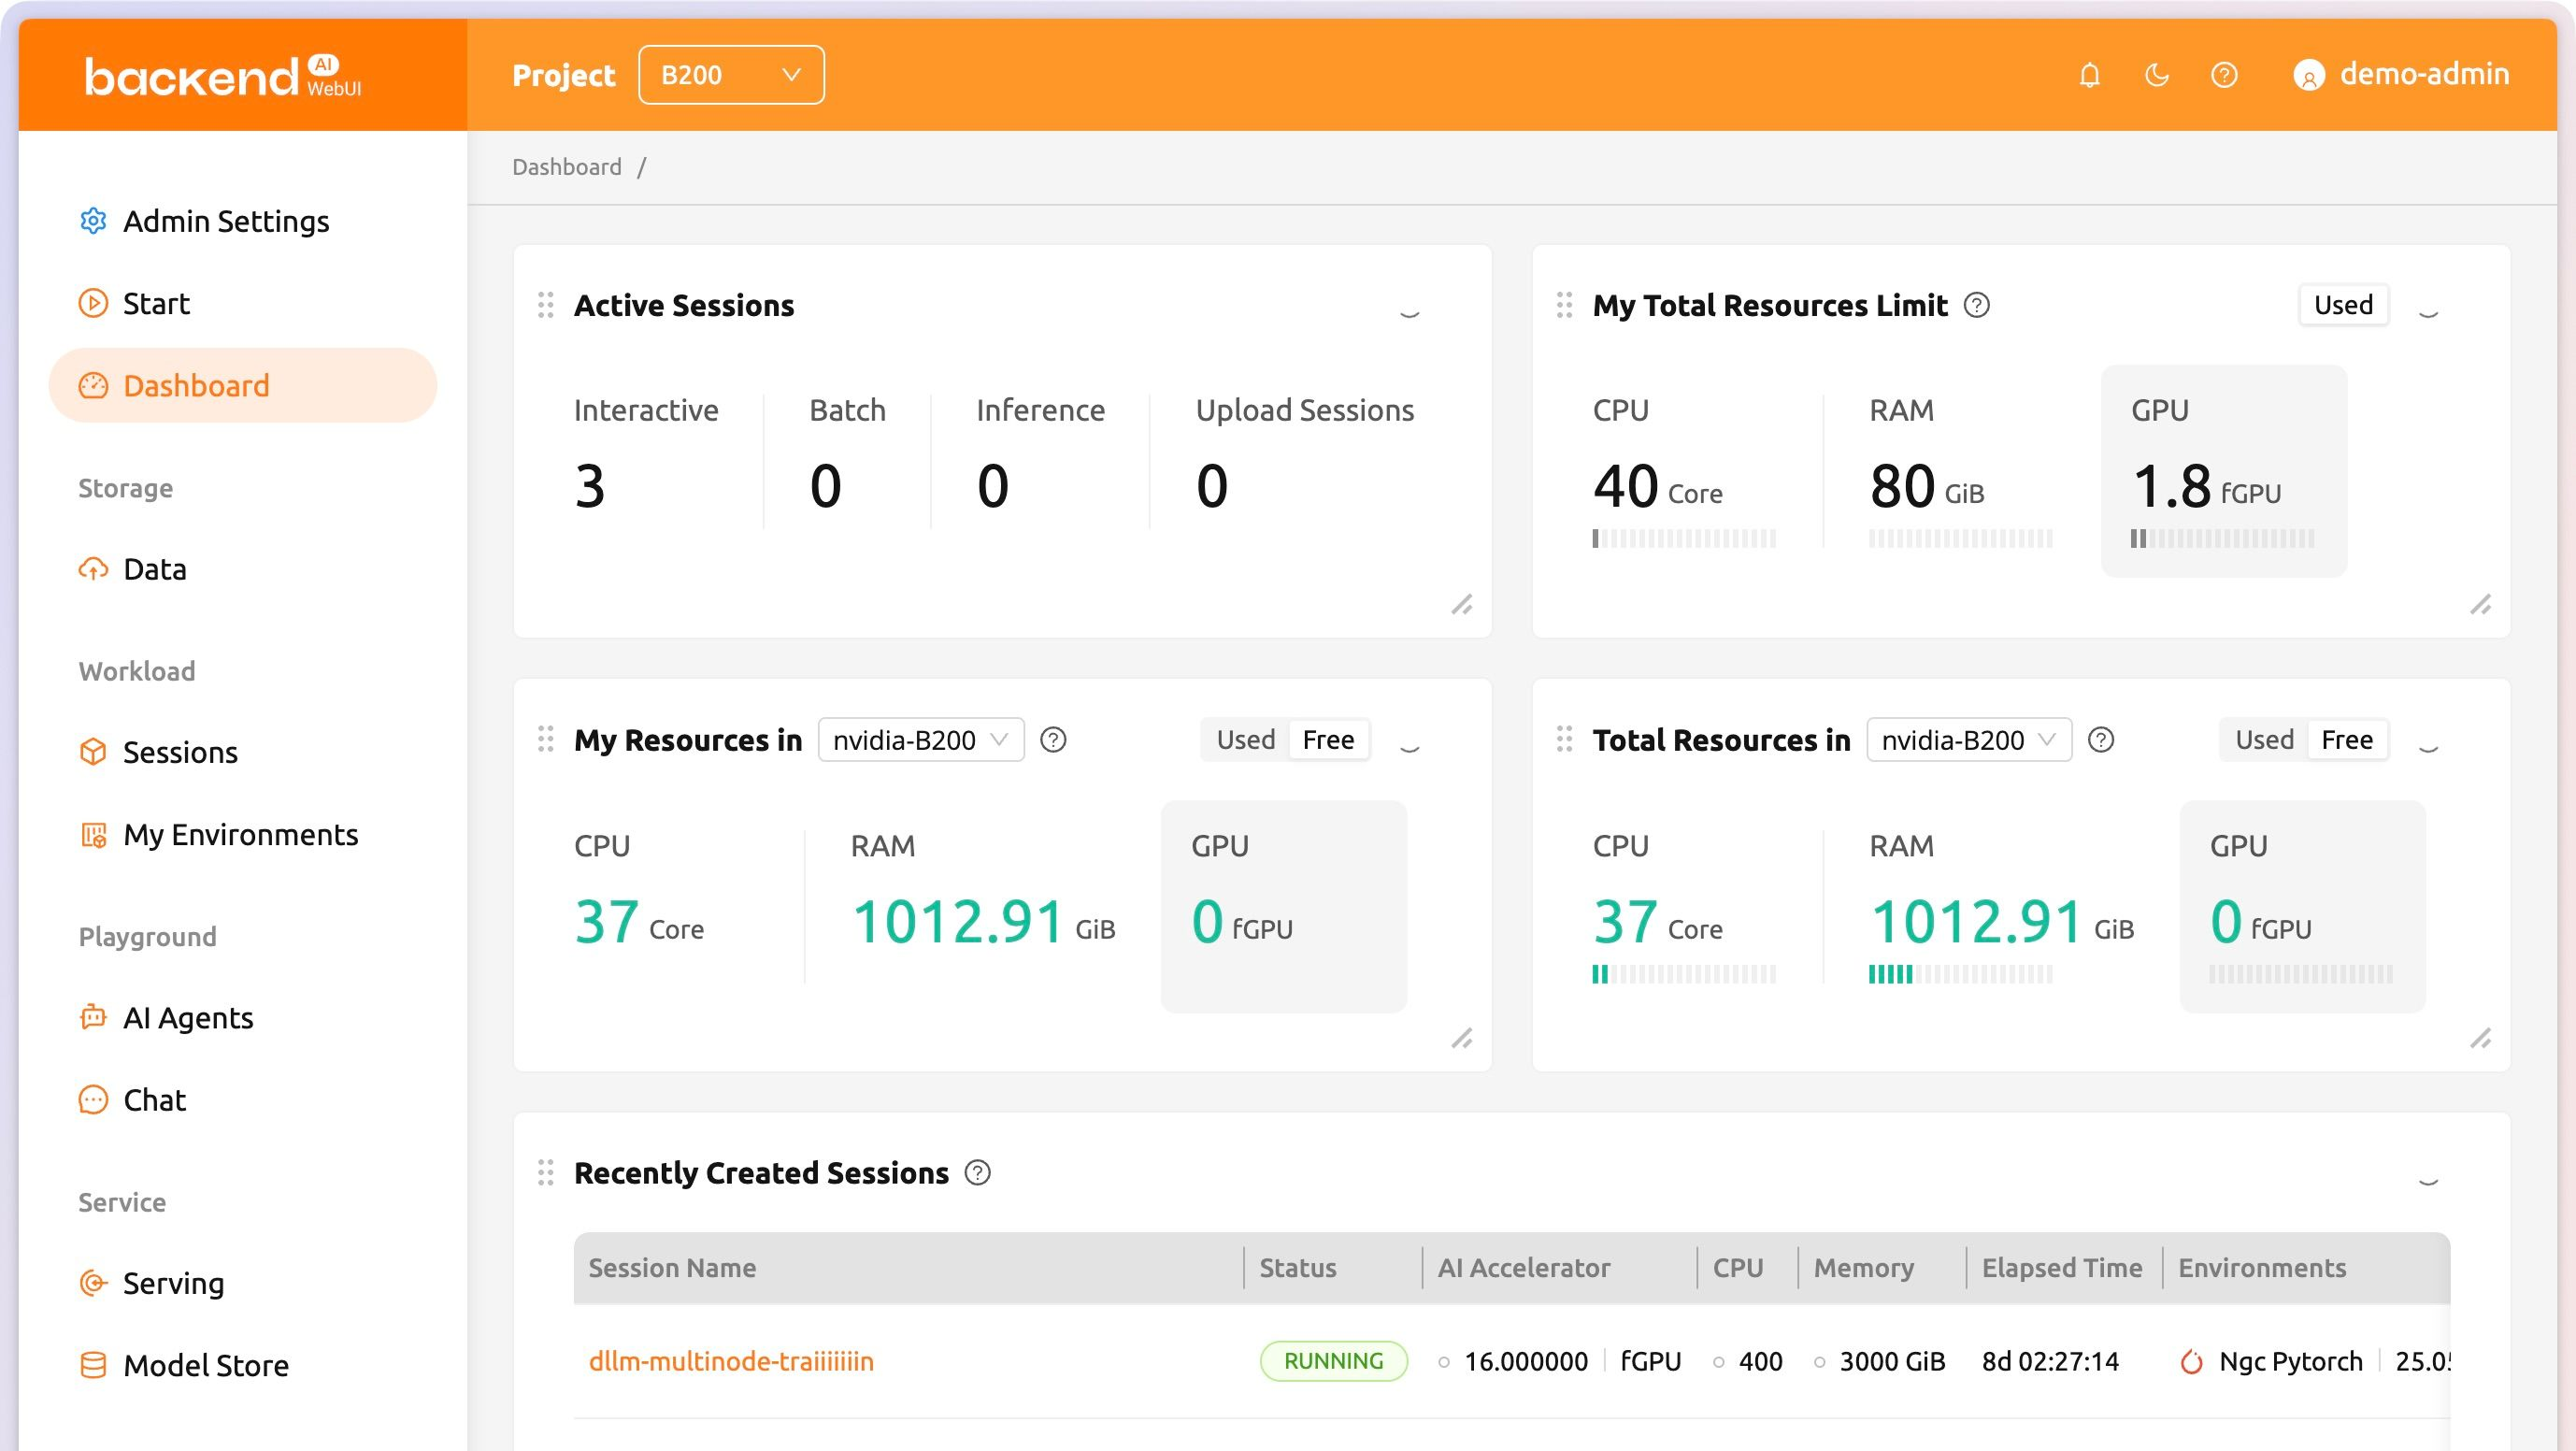
입력은 사용자·프로젝트와 실행 이미지, 필요한 CPU·메모리·GPU·저장 공간입니다. Backend.AI API로 세션 생성을 연결하는 구성을 사용할 수 있습니다. 자체 코드는 사용 가능한 이미지와 자원 종류를 보여주고 요청자의 권한을 확인합니다.
AI 학습 세션 관리에서는 환경 이미지와 코드·데이터 위치를 기록해야 재실행 조건을 확인할 수 있습니다. 허용되지 않은 저장 공간이나 네트워크에 접근하지 못하도록 정책을 적용합니다. 출력은 검증된 실행 요청이며 실제 자원이 준비되기 전에는 대기 상태로 표시합니다.
팀별 GPU 할당량과 대기 정책 적용하기
입력은 팀별 정책과 현재 사용량, 대기 중인 요청입니다. Backend.AI 스케줄러를 배정 기능의 후보로 사용하고 설치 환경에서 지원하는 정책과 자원 유형을 확인합니다. GPU 분할 등 세부 기능은 하드웨어·구성·이용 조건에 맞춰 검토합니다.
자체 관리 화면은 팀별 GPU 할당량과 우선순위, 세션의 최대 사용 범위를 설정할 수 있게 합니다. 자원이 부족하면 부족한 종류와 대기 사유를 보여줍니다. 출력은 배정 결과와 대기 상태이며 자원 반환이 확인된 뒤 다음 요청을 진행합니다.
실행 세션의 수명과 결과 관리하기
입력은 생성된 세션과 실행 작업입니다. 자체 서버는 시작·실행·종료·실패 상태를 조회하고 사용자에게 로그와 결과 파일의 위치를 연결합니다. 통신이 끊겼을 때도 세션이 실제로 종료됐는지 확인한 뒤 재시작을 결정합니다.
연구실 GPU 자원 공유에서는 장시간 유휴 세션과 중요한 실행 중 작업을 구분해야 합니다. 종료 정책을 적용하기 전 상태와 알림 기준을 정하고 필요한 결과를 보존합니다. 출력은 실제 실행 상태와 결과이며 요청 중복으로 같은 작업이 여러 세션에 생성되지 않도록 ID를 관리합니다.
GPU 사용량 모니터링 연결하기
입력은 노드·세션·프로젝트에 연결된 운영 지표입니다. Prometheus API로 실제 수집한 지표를 조회하는 구성을 사용할 수 있습니다. exporter와 수집 설정이 먼저 필요하며 GPU 종류와 수집 가능한 항목을 확인합니다.
자체 집계는 할당한 시간과 실제 사용량을 구분하고 단위와 조회 기간을 명시합니다. 수집이 빠진 구간을 사용량 0으로 처리하지 않도록 합니다. 출력은 팀별 사용량과 세션 상태이며 비용 배분에 활용하려면 계산식과 단가 버전을 별도로 관리합니다.
모델을 추론 엔드포인트로 배포하기
입력은 검증한 모델과 실행 환경, 필요한 자원과 접근 정책입니다. Backend.AI Model Serving을 활용해 추론 서비스를 구성할 수 있습니다. 자체 배포 흐름은 모델 로딩과 입력·출력 검사, 응답 시간과 오류율을 확인합니다.
AI 모델 서빙에서는 배포 요청 성공과 실제 요청 처리 가능 상태를 구분합니다. 이전 모델 버전과 되돌리는 절차를 관리하고 엔드포인트의 접근 권한과 사용량 제한을 적용합니다. 필요한 연산 규모와 팀별 운영 방식을 정리해 트램스 AI에 제작을 문의해 주세요: https://trams.co.kr/ai-si/contact/#inquiry
참고 자료
- https://www.backend.ai/
- https://docs.backend.ai/
- https://prometheus.io/docs/prometheus/latest/querying/api/
- https://kubernetes.io/docs/concepts/overview/kubernetes-api/
- https://docs.slack.dev/apis/web-api/
- https://www.backend.ai/ko
- https://www.backend.ai/platform/webui
- https://www.backend.ai/pricing
- https://www.hankyung.com/article/2025040886711
- https://kubernetes.io/docs/tasks/manage-gpus/scheduling-gpus/
- https://kubernetes.io/docs/concepts/policy/resource-quotas/
- https://kubernetes.io/docs/reference/using-api/api-concepts/
- https://kserve.github.io/website/docs/getting-started/predictive-first-isvc
비슷한 AI 서비스를
사업에 적용하고 싶으신가요?
아이디어와 필요한 기능을 알려주시면 제작 범위와 방법을 검토합니다.