Vrew처럼 텍스트 기반 영상 편집 서비스를 만드는 방법
Vrew의 자동 자막·문장 컷편집·영상 합성 흐름을 살펴봅니다. Deepgram, FFmpeg, Creatomate로 유사 기능을 구현하는 방법과 직접 개발할 편집 규칙, 한국어 지원 및 출력 방식의 선택 기준을 설명합니다.
강의·인터뷰 영상의 자막 입력과 편집 구간 탐색이 반복된다면 Vrew의 작업 흐름을 참고할 수 있습니다. 음성을 시간 정보가 있는 자막으로 바꾸고, 텍스트 선택을 컷 편집과 완성 영상 출력으로 연결합니다. 유사 서비스를 만들 때는 음성 인식 API의 지원 범위와 직접 구현할 편집 규칙을 구분해야 합니다.
Vrew에서 자막 생성부터 편집까지 따라가기
Vrew는 음성을 자막으로 바꾸고 텍스트를 보면서 편집하는 AI 영상 편집 프로그램입니다. 자막 입력과 편집 구간 탐색의 부담을 줄이는 데 핵심 가치가 있습니다.
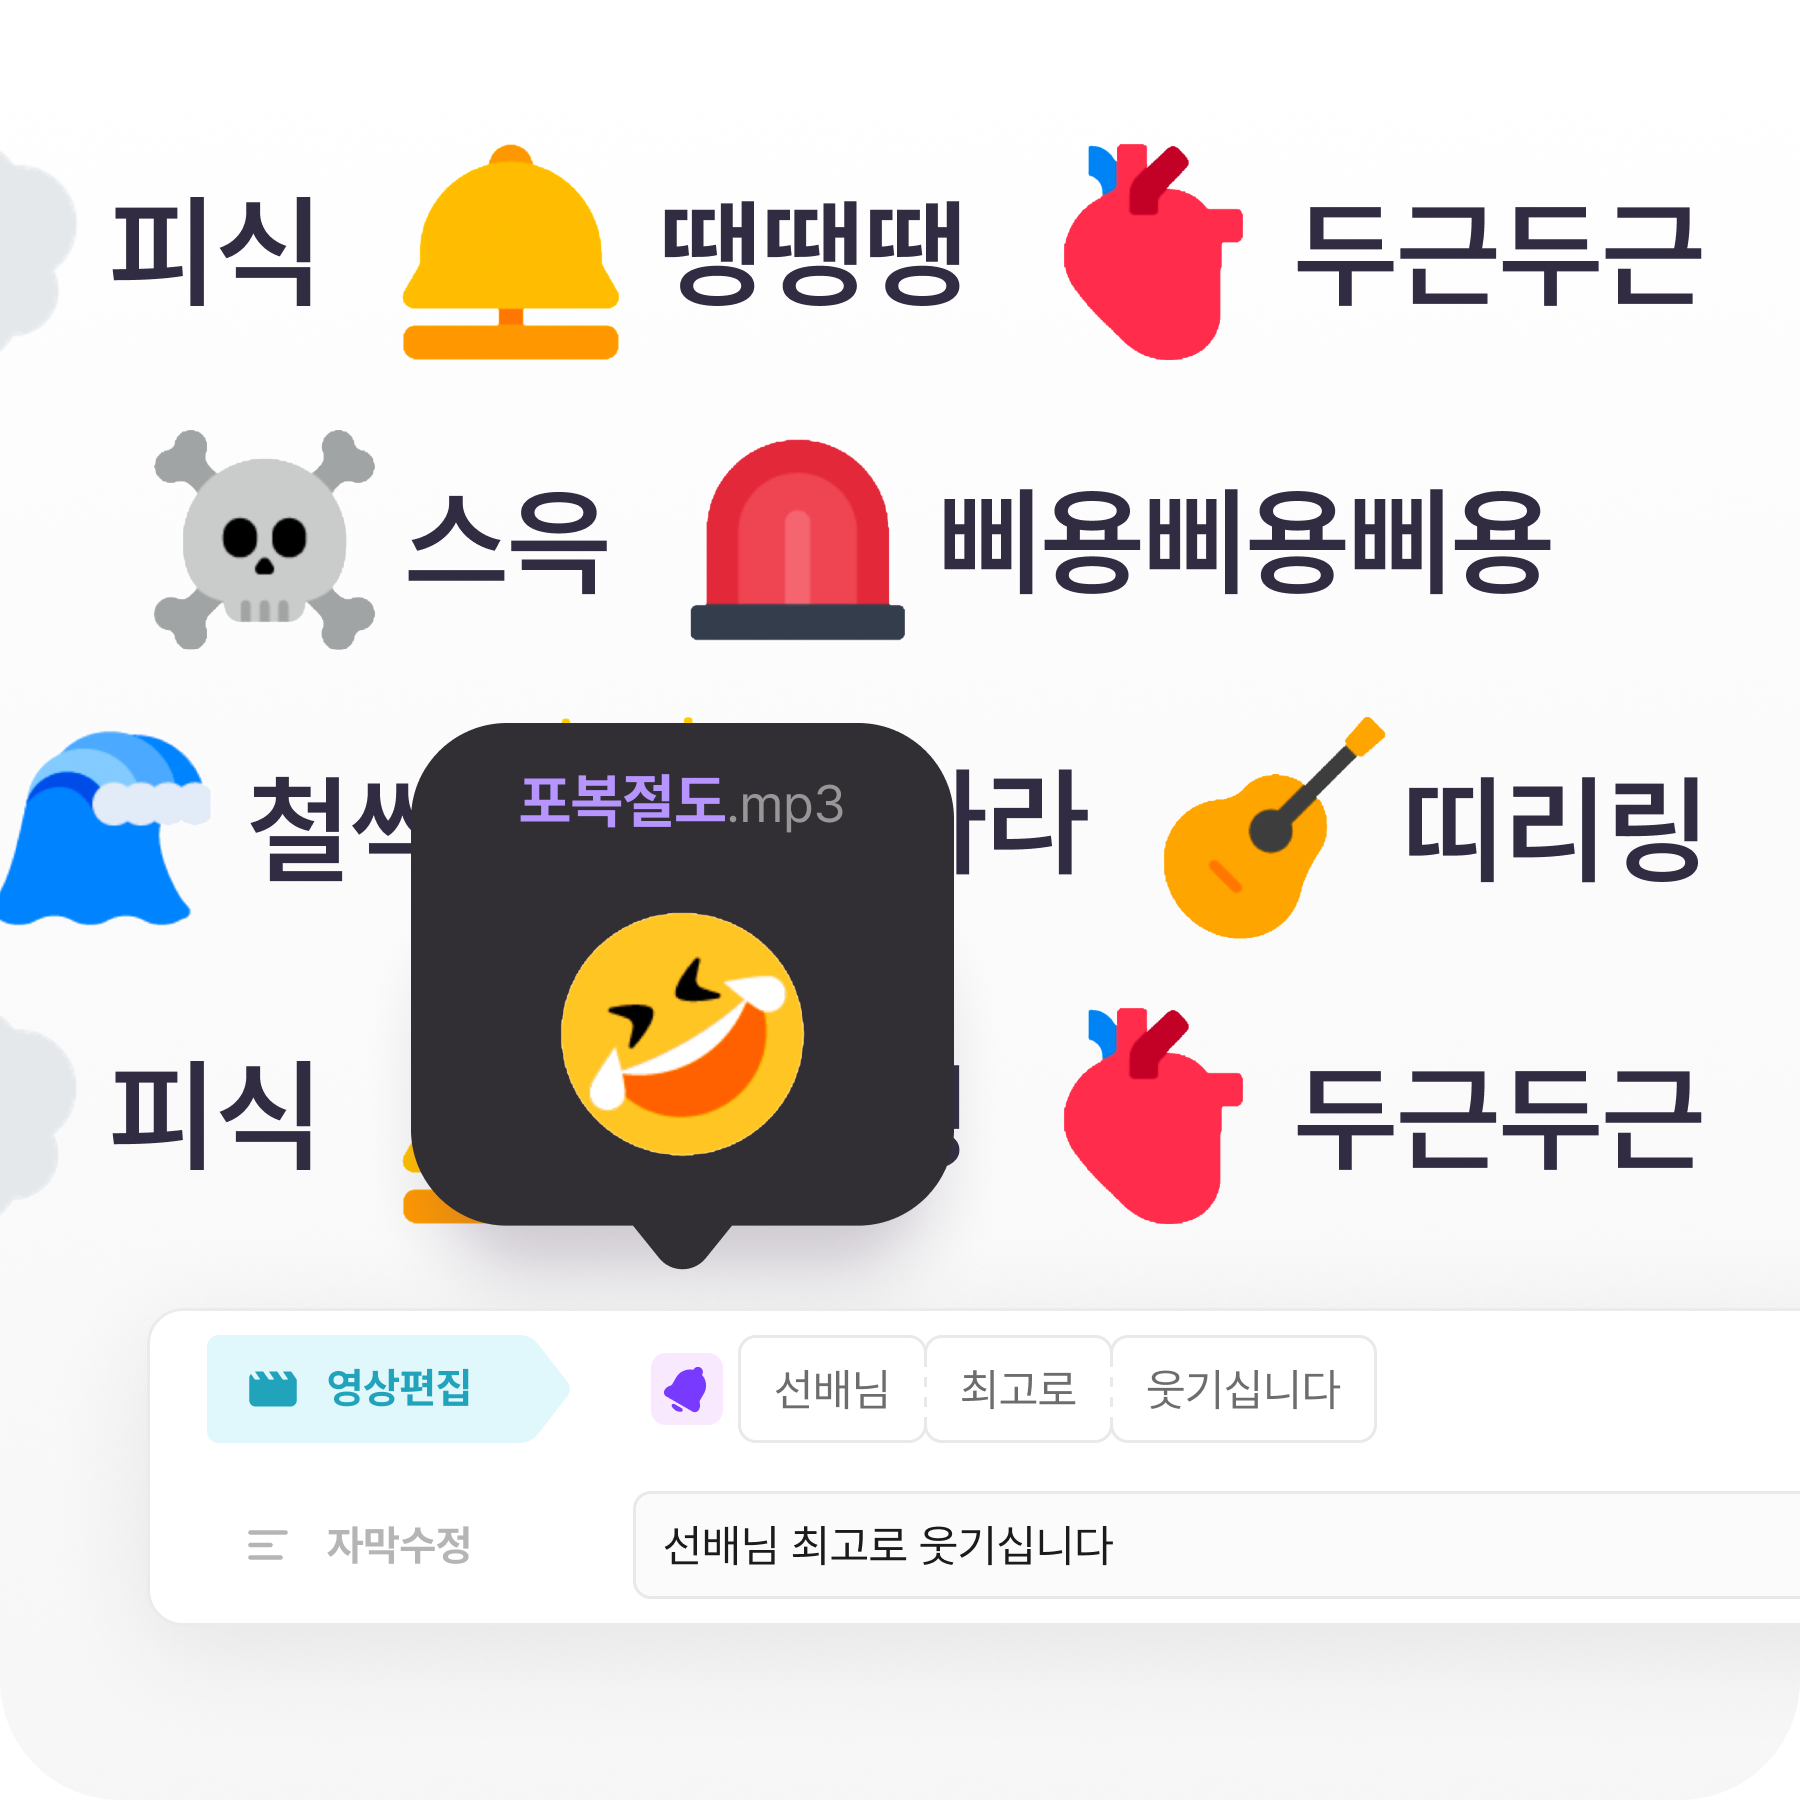
Vrew 자동 자막의 작업 순서는 영상 불러오기, 자막 생성, 문구 검토, 구간 편집, 내보내기로 이어집니다. 강의 영상에서는 원고를 활용해 자막을 보완하고 전문용어를 검토할 수 있습니다. 편집한 영상에는 이미지·비디오·배경음악 등의 소재를 추가하고 위치와 시간을 조절할 수 있습니다.
영상 자막 오타 수정과 인터뷰 영상 컷편집은 구분해야 합니다. 전자는 표시할 문구를 고치는 작업이고, 후자는 선택한 영상·음성 구간을 덜어내는 작업입니다. 유사 편집기를 설계할 때도 두 동작을 사용자가 구별할 수 있도록 구성합니다.
음성을 시간 정보가 있는 텍스트로 바꾸기
이하의 기술 구성은 Vrew의 내부 기술을 설명하는 것이 아니라 유사 기능을 만드는 구현 대안입니다. 첫 단계는 영상에서 얻은 음성을 인식해 시간 정보가 있는 텍스트로 변환하는 것입니다.
Deepgram은 음성을 텍스트로 바꾸는 STT AI API 후보입니다. 녹음 파일 전사 응답에는 단어와 시작·종료 시간, 신뢰도가 포함됩니다. 단어 타임스탬프 자막 생성은 이 정보를 활용해 자막이 표시될 구간을 구성하는 방식입니다.
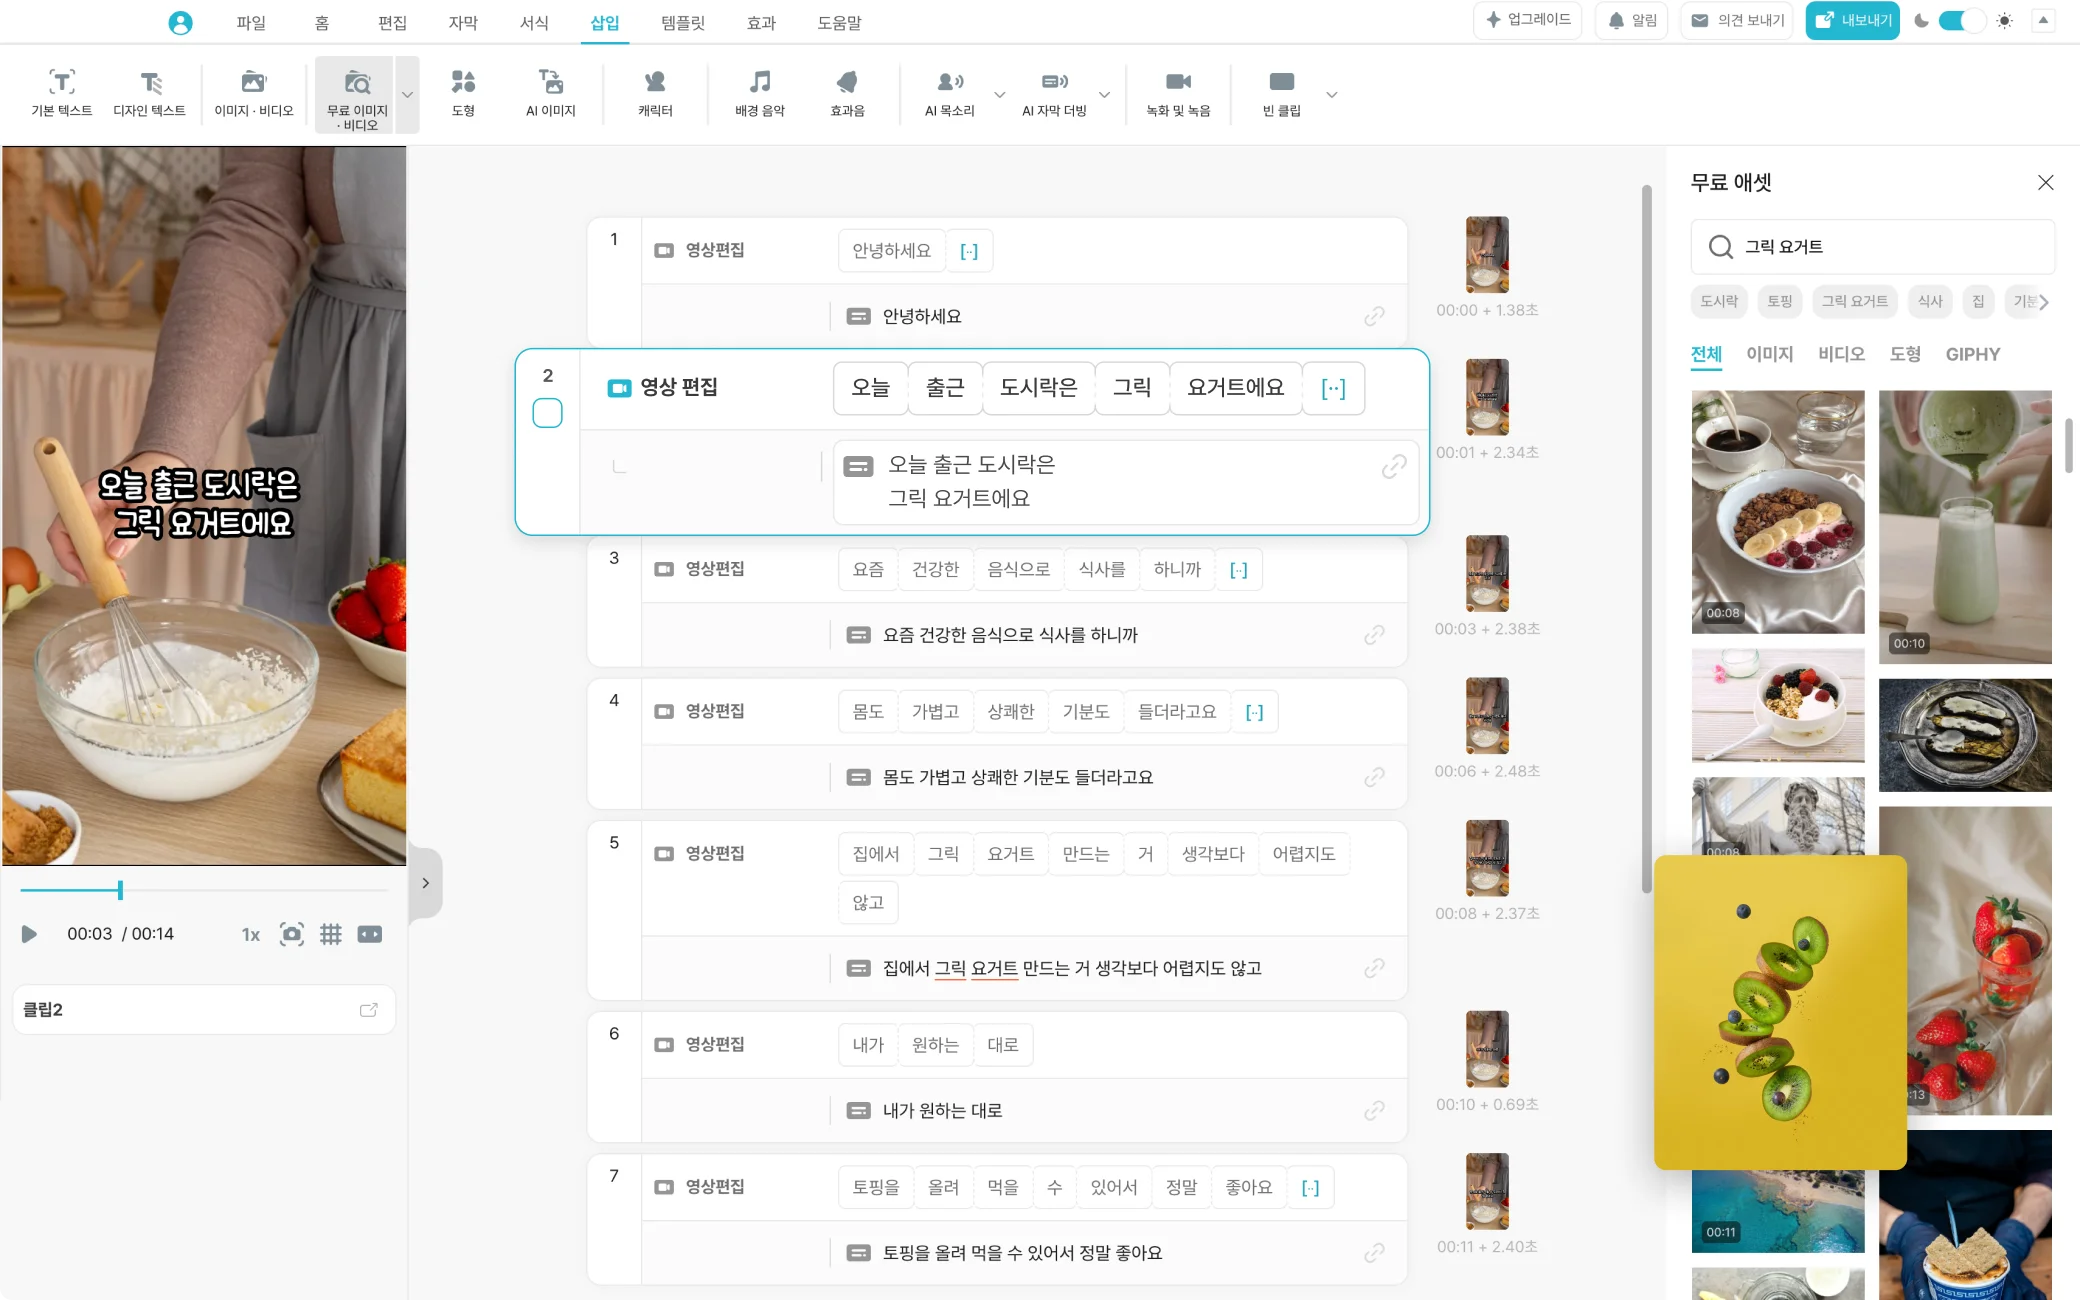
자동 자막 서비스 개발에서는 단어를 문장으로 묶는 기준과 줄바꿈 규칙을 직접 구현합니다. 사용자 교정 화면도 필요합니다. 음성 인식 API가 편집 화면이나 컷 구간 계산까지 대신하지는 않습니다.
한국어 STT API를 선택할 때는 모델별 언어 지원을 확인합니다. 2026년 10월 19일 확인된 문서 기준으로 Deepgram Nova-3와 Nova-2는 한국어를 지원합니다. 다만 Nova-3의 다국어 혼용 지원 목록에는 한국어가 포함되지 않아, 한국어 단독 인식과 여러 언어가 섞인 녹음 처리를 같은 조건으로 보면 안 됩니다.
텍스트 선택을 영상 구간 편집으로 연결하기
두 번째 단계의 입력은 사용자가 선택한 문장과 해당 문장의 원본 시간 정보입니다. 애플리케이션은 이 연결을 바탕으로 남길 구간과 삭제할 구간을 계산합니다. 문구 교정만 한 경우에는 영상 구간 삭제로 처리하지 않도록 동작을 나눠 설계합니다.
FFmpeg는 계산된 구간을 처리할 오픈소스 미디어 도구입니다. trim·atrim으로 영상과 음성의 구간을 처리하고, concat으로 남은 구간을 연결하는 구성을 제안할 수 있습니다. 출력은 선택 사항이 반영된 편집 영상입니다.
문장과 원본 시간의 연결, 편집 후 자막 시간 재계산, 되돌리기는 자체 애플리케이션 로직의 역할입니다. 예를 들어 중간의 5초를 삭제하면 뒤에 남는 자막도 그만큼 앞당겨야 합니다. 이 규칙을 함께 적용해야 편집 후 영상과 자막의 시간이 맞습니다.
확정 자막과 소재를 완성 영상으로 합성하기
세 번째 단계에서는 확정 자막, 편집 영상, 이미지와 오디오 등의 소재를 입력받습니다. Creatomate 영상 렌더링 API는 템플릿과 수정값 또는 RenderScript JSON이라는 구성 정보를 받아 이를 완성 영상으로 합성하는 후보입니다. 생성형 AI 모델이나 영상 소재 공급원과는 역할이 다릅니다.
자막의 위치, 소재의 표시 길이, 배경음악의 음량은 프로그램에서 지정합니다. 렌더링 완료는 완료 알림인 webhook이나 상태 조회로 확인하고, 실패 시 재시도와 사용자 안내도 직접 구현합니다.
자막을 영상에 입히는 처리를 직접 구성한다면 FFmpeg의 subtitles 필터와 libass를 활용하는 방법도 있습니다. FFmpeg는 미디어 처리 도구이고, libass는 자막을 화면에 그리는 라이브러리입니다. 외부 렌더링 API에 맡길 범위와 직접 운영할 범위를 먼저 정합니다.
내보내기 방식과 이용 환경을 확인하기
자막이 입혀진 영상과 별도 SRT 자막 파일은 용도가 다릅니다. 전자는 자막이 영상 화면의 일부가 된 결과물입니다. 후자는 자막 문구와 표시 시간을 담아 유튜브 CC나 다른 편집 도구에 전달할 때 활용합니다.
브루 SRT 내보내기는 자동 생성된 자막을 검토한 뒤 별도 파일로 저장하는 기능입니다. 외부에서 수정한 SRT를 다시 가져오는 기능도 안내되어 있습니다. 유사 서비스를 만들 때도 영상 출력과 자막 파일 출력을 별도 요구사항으로 정합니다.
한국어 공식 안내에는 Mac·Windows·Ubuntu 지원과 웹 체험이 소개되어 있습니다. 설치형 프로그램과 웹 체험의 제공 범위를 동일하게 전제하지 말고, 사용할 제품 버전과 환경에서 필요한 기능을 확인합니다. 별도 서비스에 넣을 소재는 공급원과 이용 권한을 따로 확보합니다.
필요한 기능부터 제작 범위 정하기
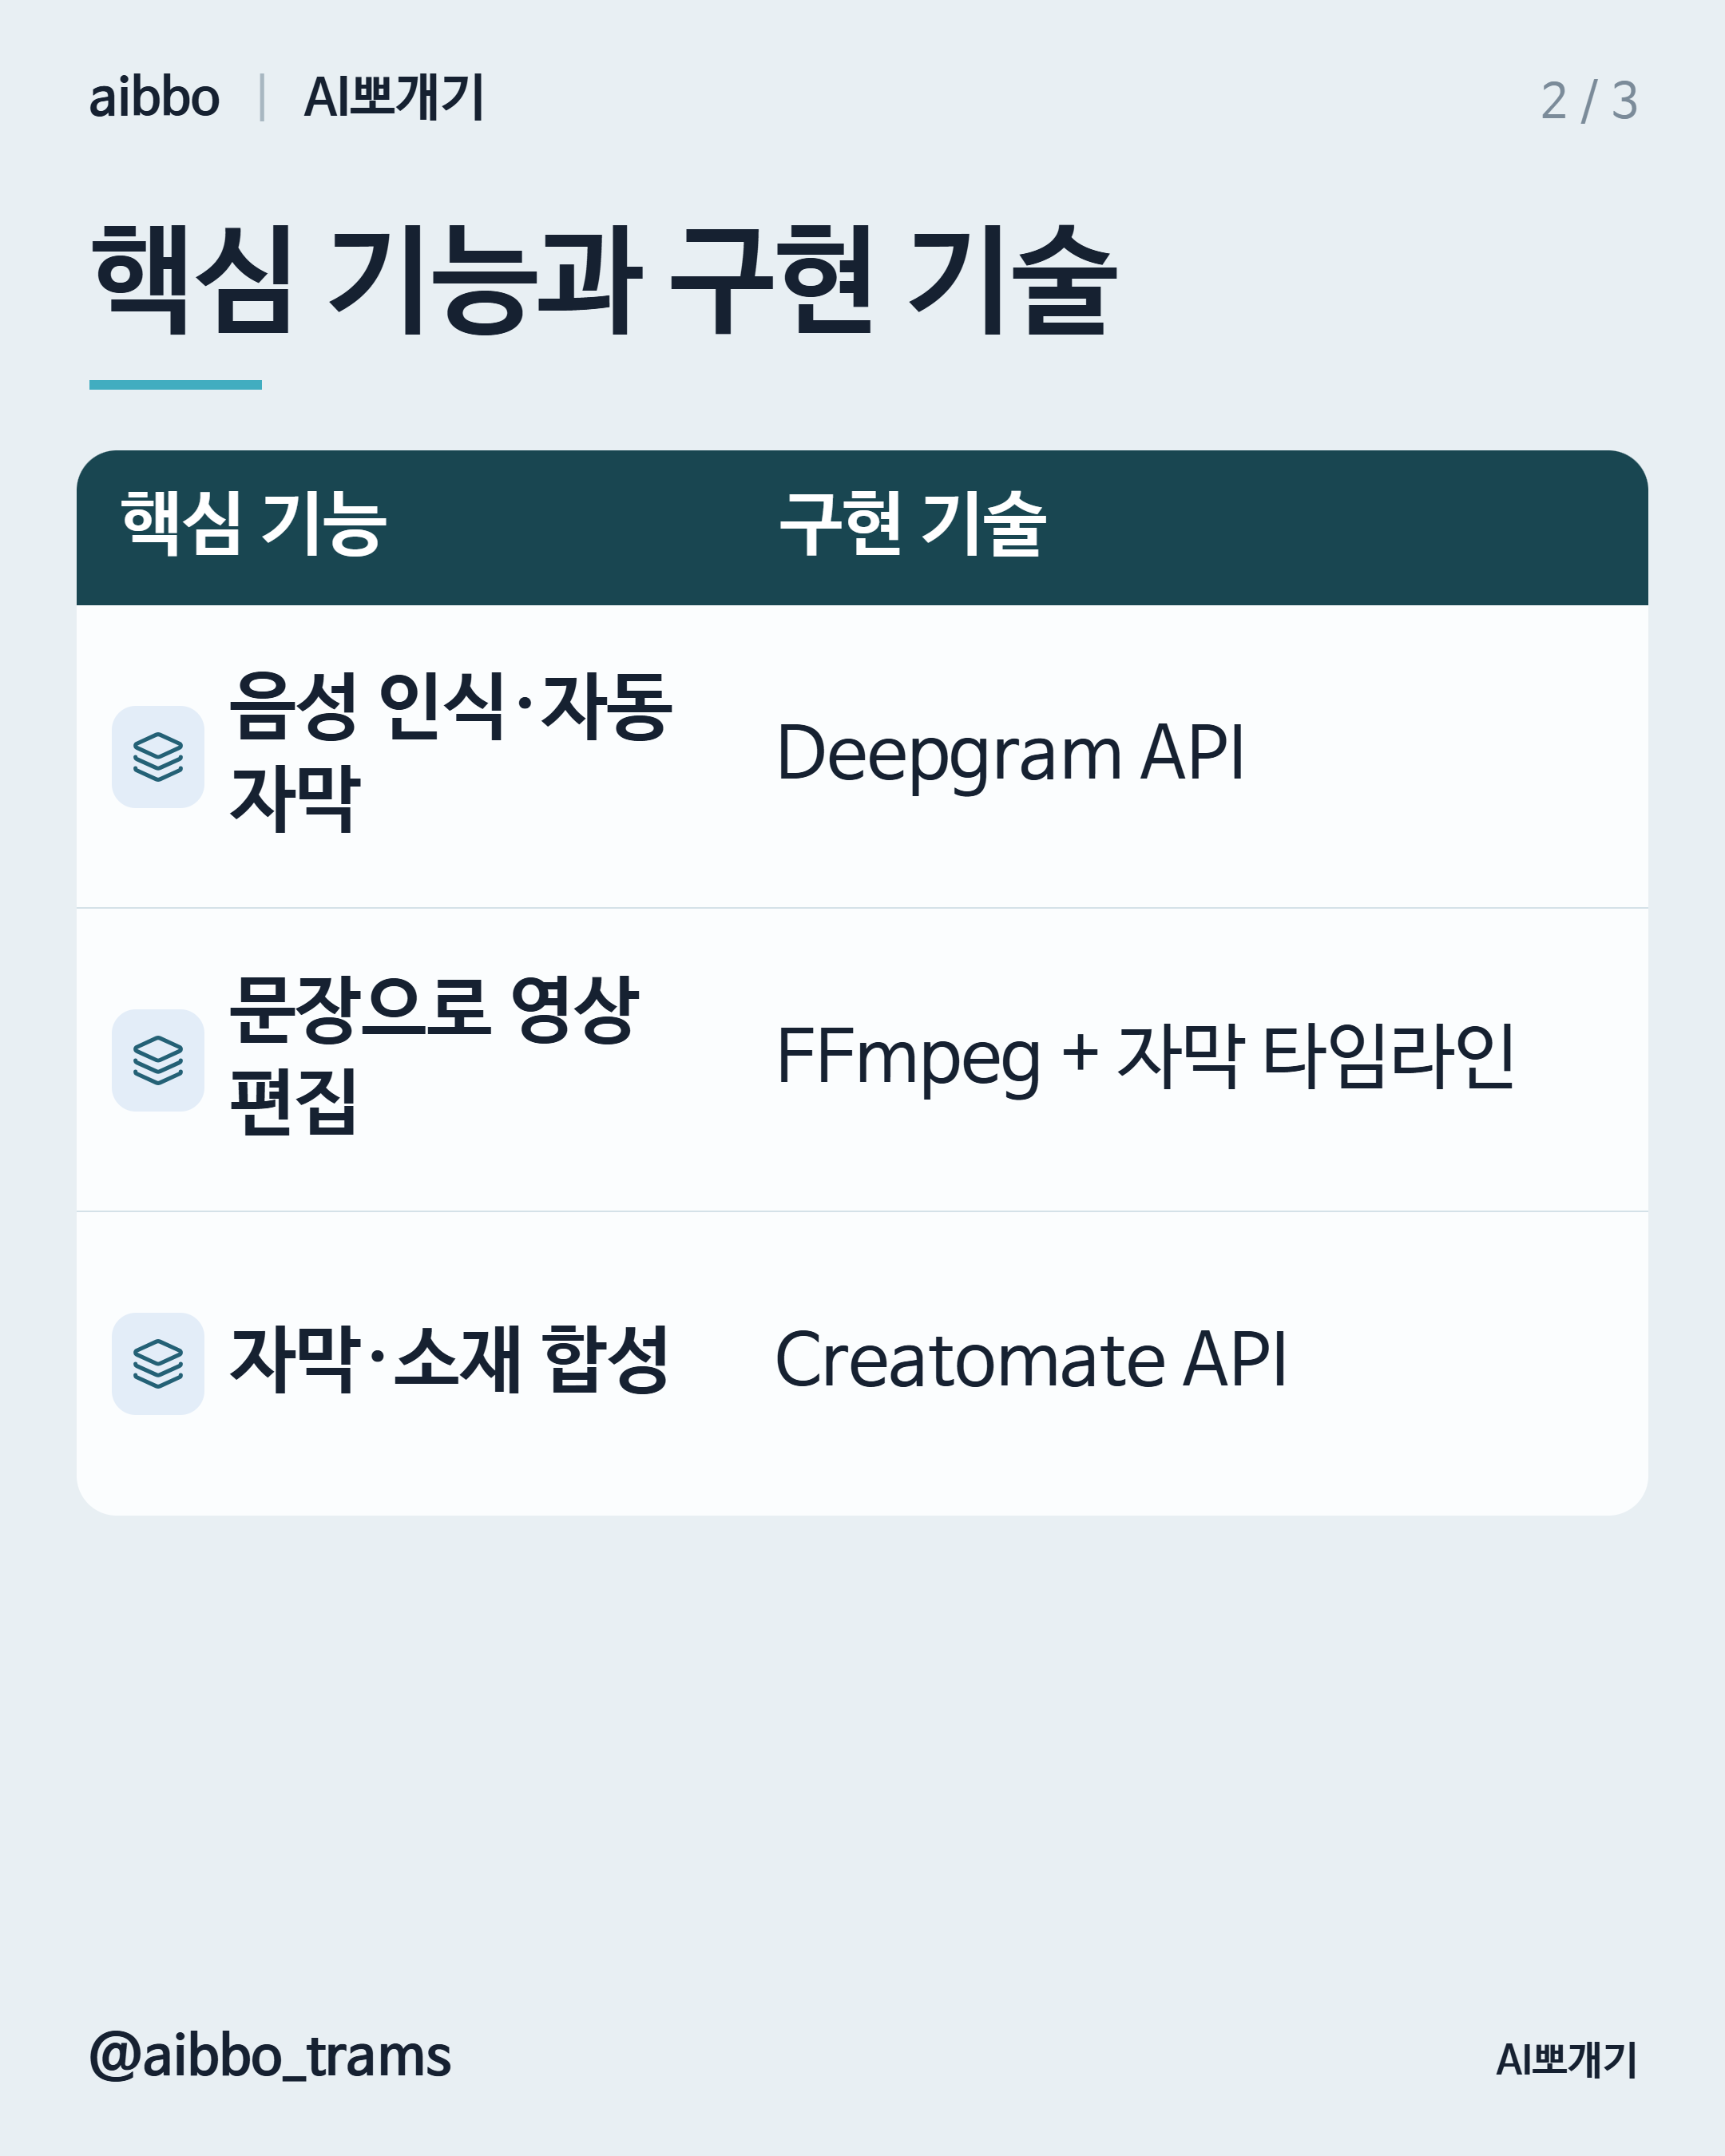
음성 인식은 AI API, 구간 처리는 오픈소스 도구, 최종 합성은 렌더링 API로 나눠 설계할 수 있습니다. 그 사이를 연결하는 시간 계산과 편집 상태 관리, 사용자 검토는 자체 로직으로 구현합니다.
먼저 입력 영상 한 편을 기준으로 필요한 자막 교정, 컷 편집, 출력 방식을 정리해 보세요. 유사 영상 편집 서비스 제작을 준비한다면 이 요구사항을 바탕으로 트램스 AI에 문의해 주세요: https://trams.co.kr/ai-si/contact/#inquiry
참고 자료
- https://vrew.ai/ko/
- https://vrew.ai/ko/feature/ai-video-subtitle/
- https://vrew.ai/ko/feature/text-based-video-editing/
- https://vrew.ai/ko/feature/free-video-asset/
- https://vrew.ai/ko/feature/srt-export/
- https://developers.deepgram.com/reference/speech-to-text/listen-pre-recorded
- https://developers.deepgram.com/docs/models-languages-overview
- https://ffmpeg.org/ffmpeg-filters.html
- https://creatomate.com/docs/fundamentals/getting-started/api-automation
비슷한 AI 서비스를
사업에 적용하고 싶으신가요?
아이디어와 필요한 기능을 알려주시면 제작 범위와 방법을 검토합니다.