업스테이지 Document Parse로 스캔 PDF의 글자와 표를 구조화하는 방법
업스테이지 Document Parse의 문자 인식·표 분석·출력 흐름을 설명합니다. 모드와 버전별 지원 조건, Docling·Azure를 활용한 유사 기능 구현, 검증과 RAG 연결에 필요한 단계를 살펴봅니다.
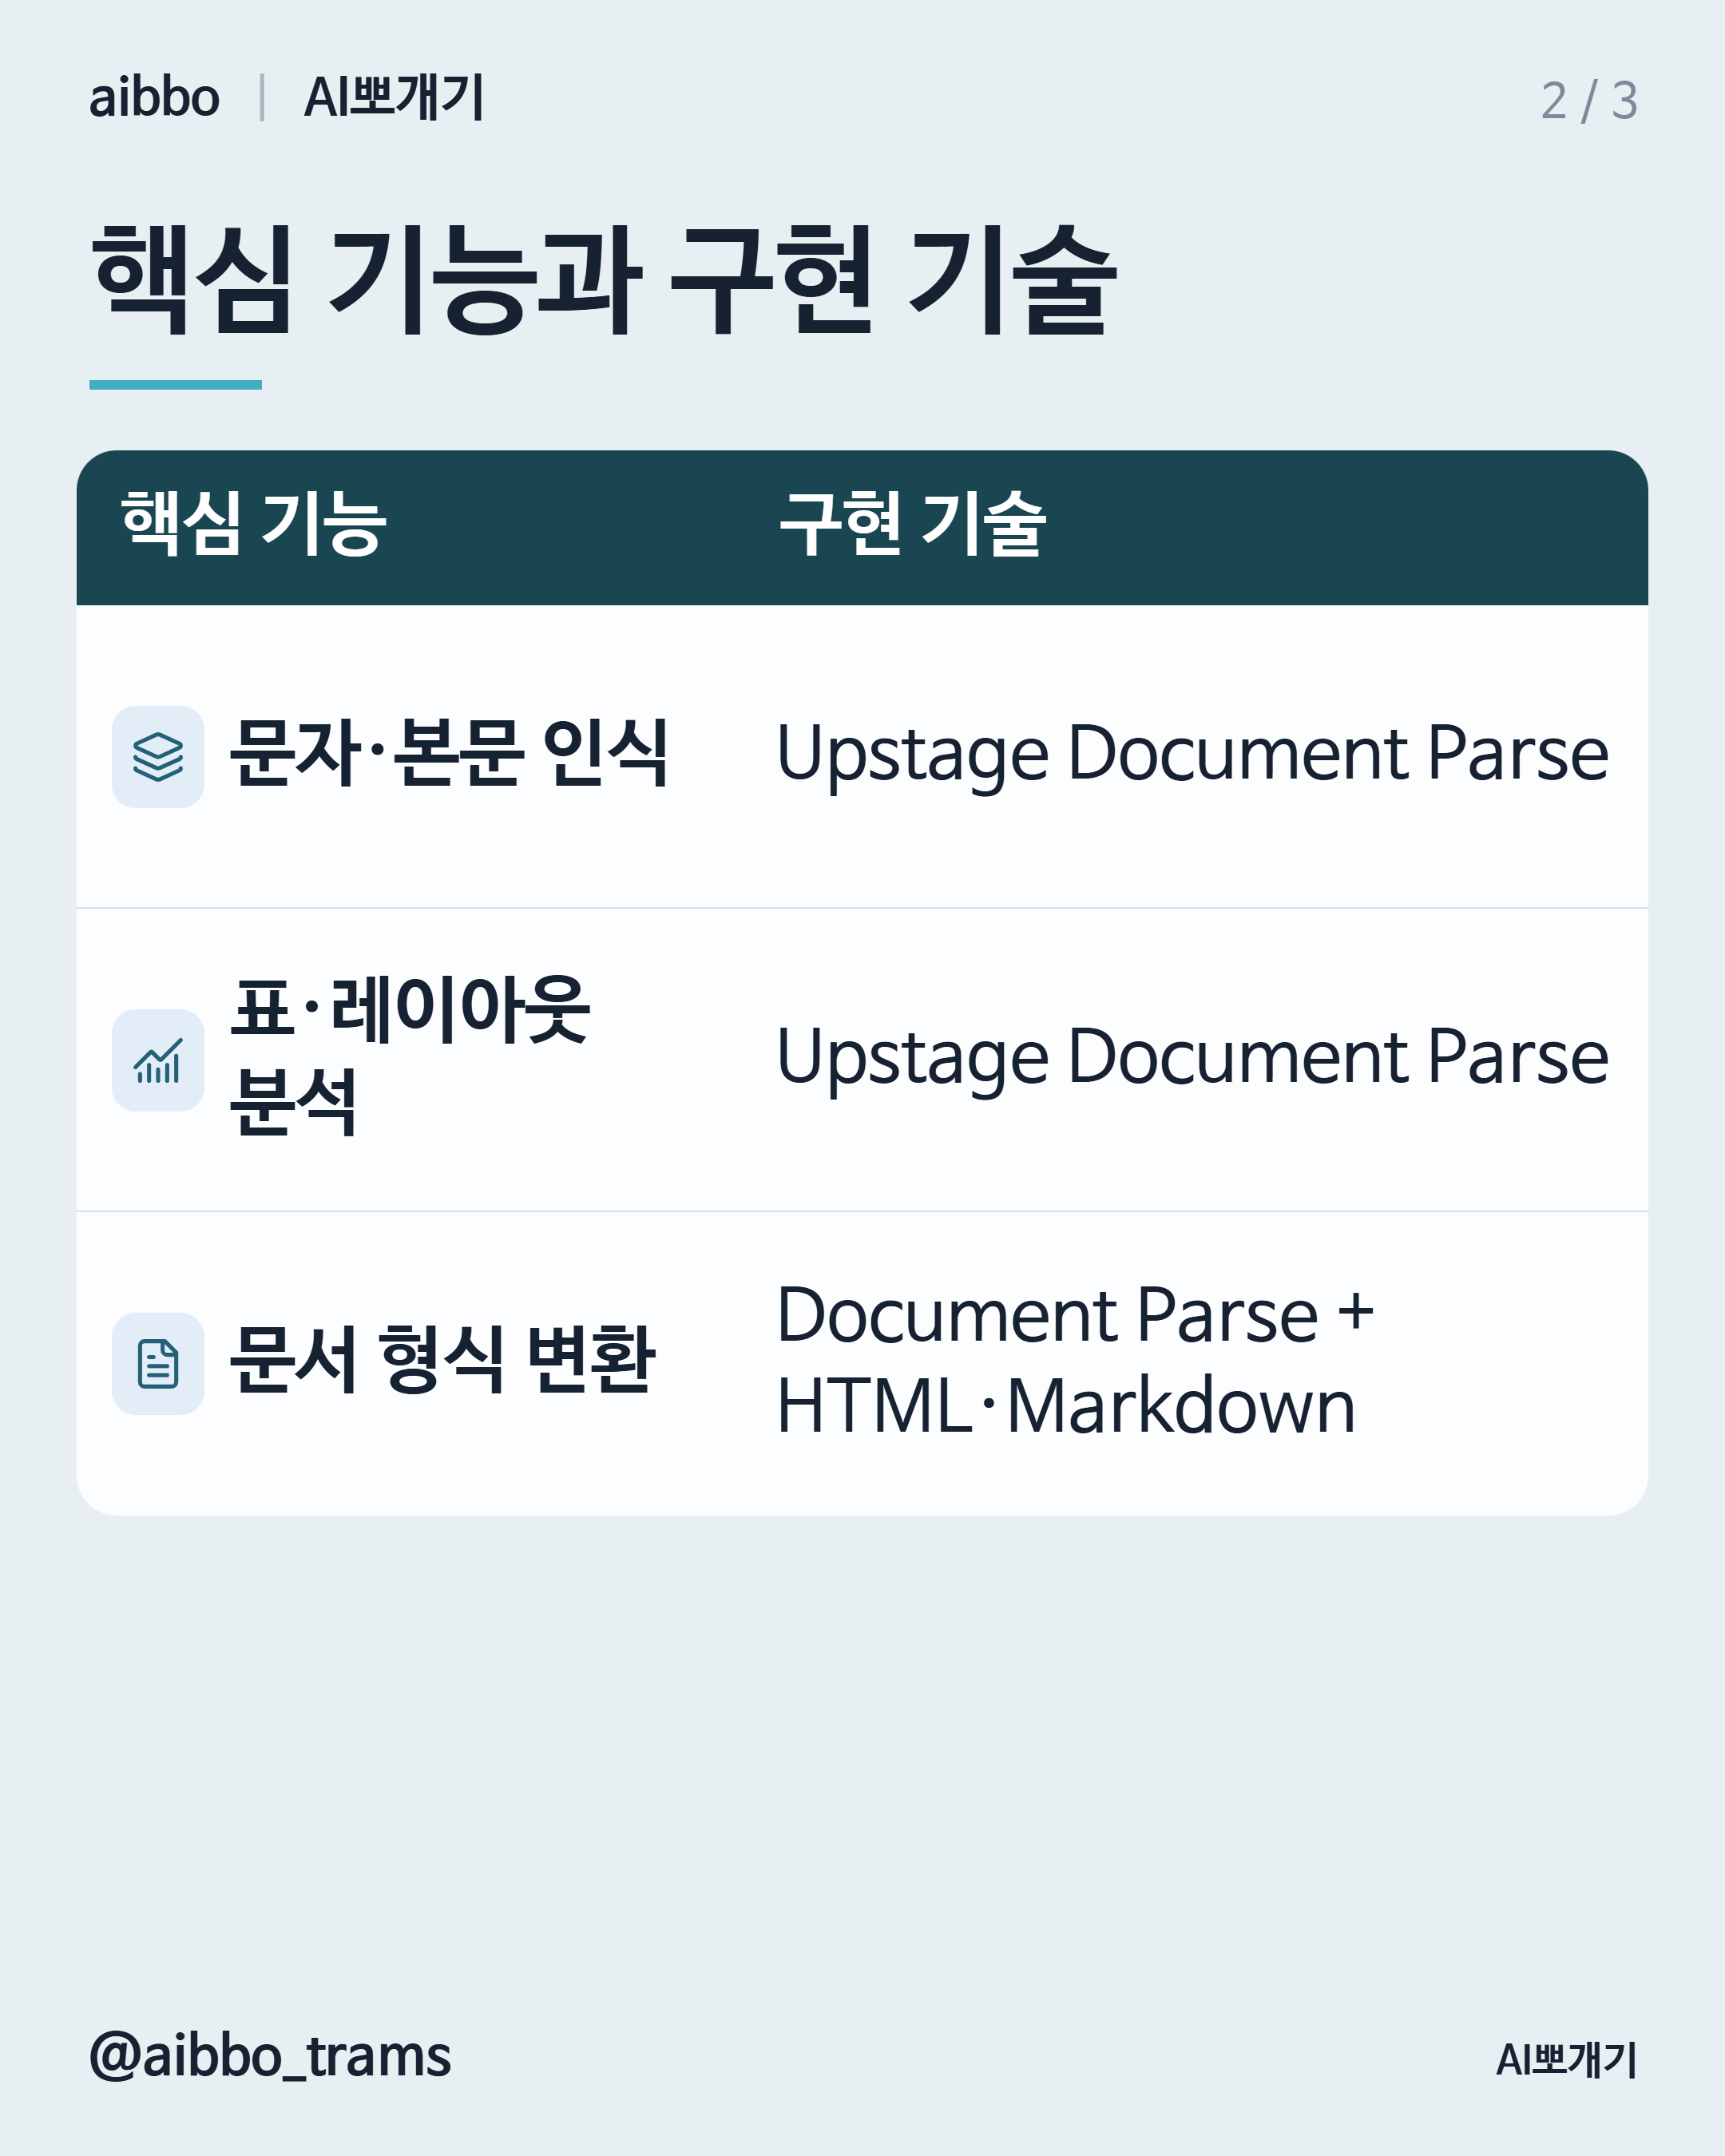
스캔 PDF에서 글자가 복사되지 않거나 표가 흐트러질 때 문서 구조까지 추출하는 방법을 살펴봅니다. 업스테이지 Document Parse는 문자 인식과 레이아웃 분석으로 본문·표·좌표를 후속 처리에 쓸 수 있게 정리합니다. 문서 유형과 모델 버전을 확인하고, 검색·답변 생성과 업무 데이터 검증은 별도 단계로 설계합니다.
글자 추출을 넘어 표와 문단의 관계를 읽습니다
금융 보고서를 복사했는데 숫자가 어느 항목에 속하는지 알 수 없다면, 글자만 추출해서는 업무에 쓰기 어렵습니다. 업스테이지 Document Parse의 핵심 가치는 문서의 내용을 구조와 함께 꺼내는 데 있습니다.
OCR은 이미지 속 글자를 인식하는 기술입니다. 문서 파싱은 여기에 제목·본문 구분, 읽기 순서, 표의 행·열 관계를 더해 결과를 정리하는 과정입니다. 스캔 PDF 텍스트 추출과 PDF 표 구조 인식을 함께 고려해야 재정리할 대상을 줄일 수 있습니다.
입력 문서를 세 단계로 변환합니다
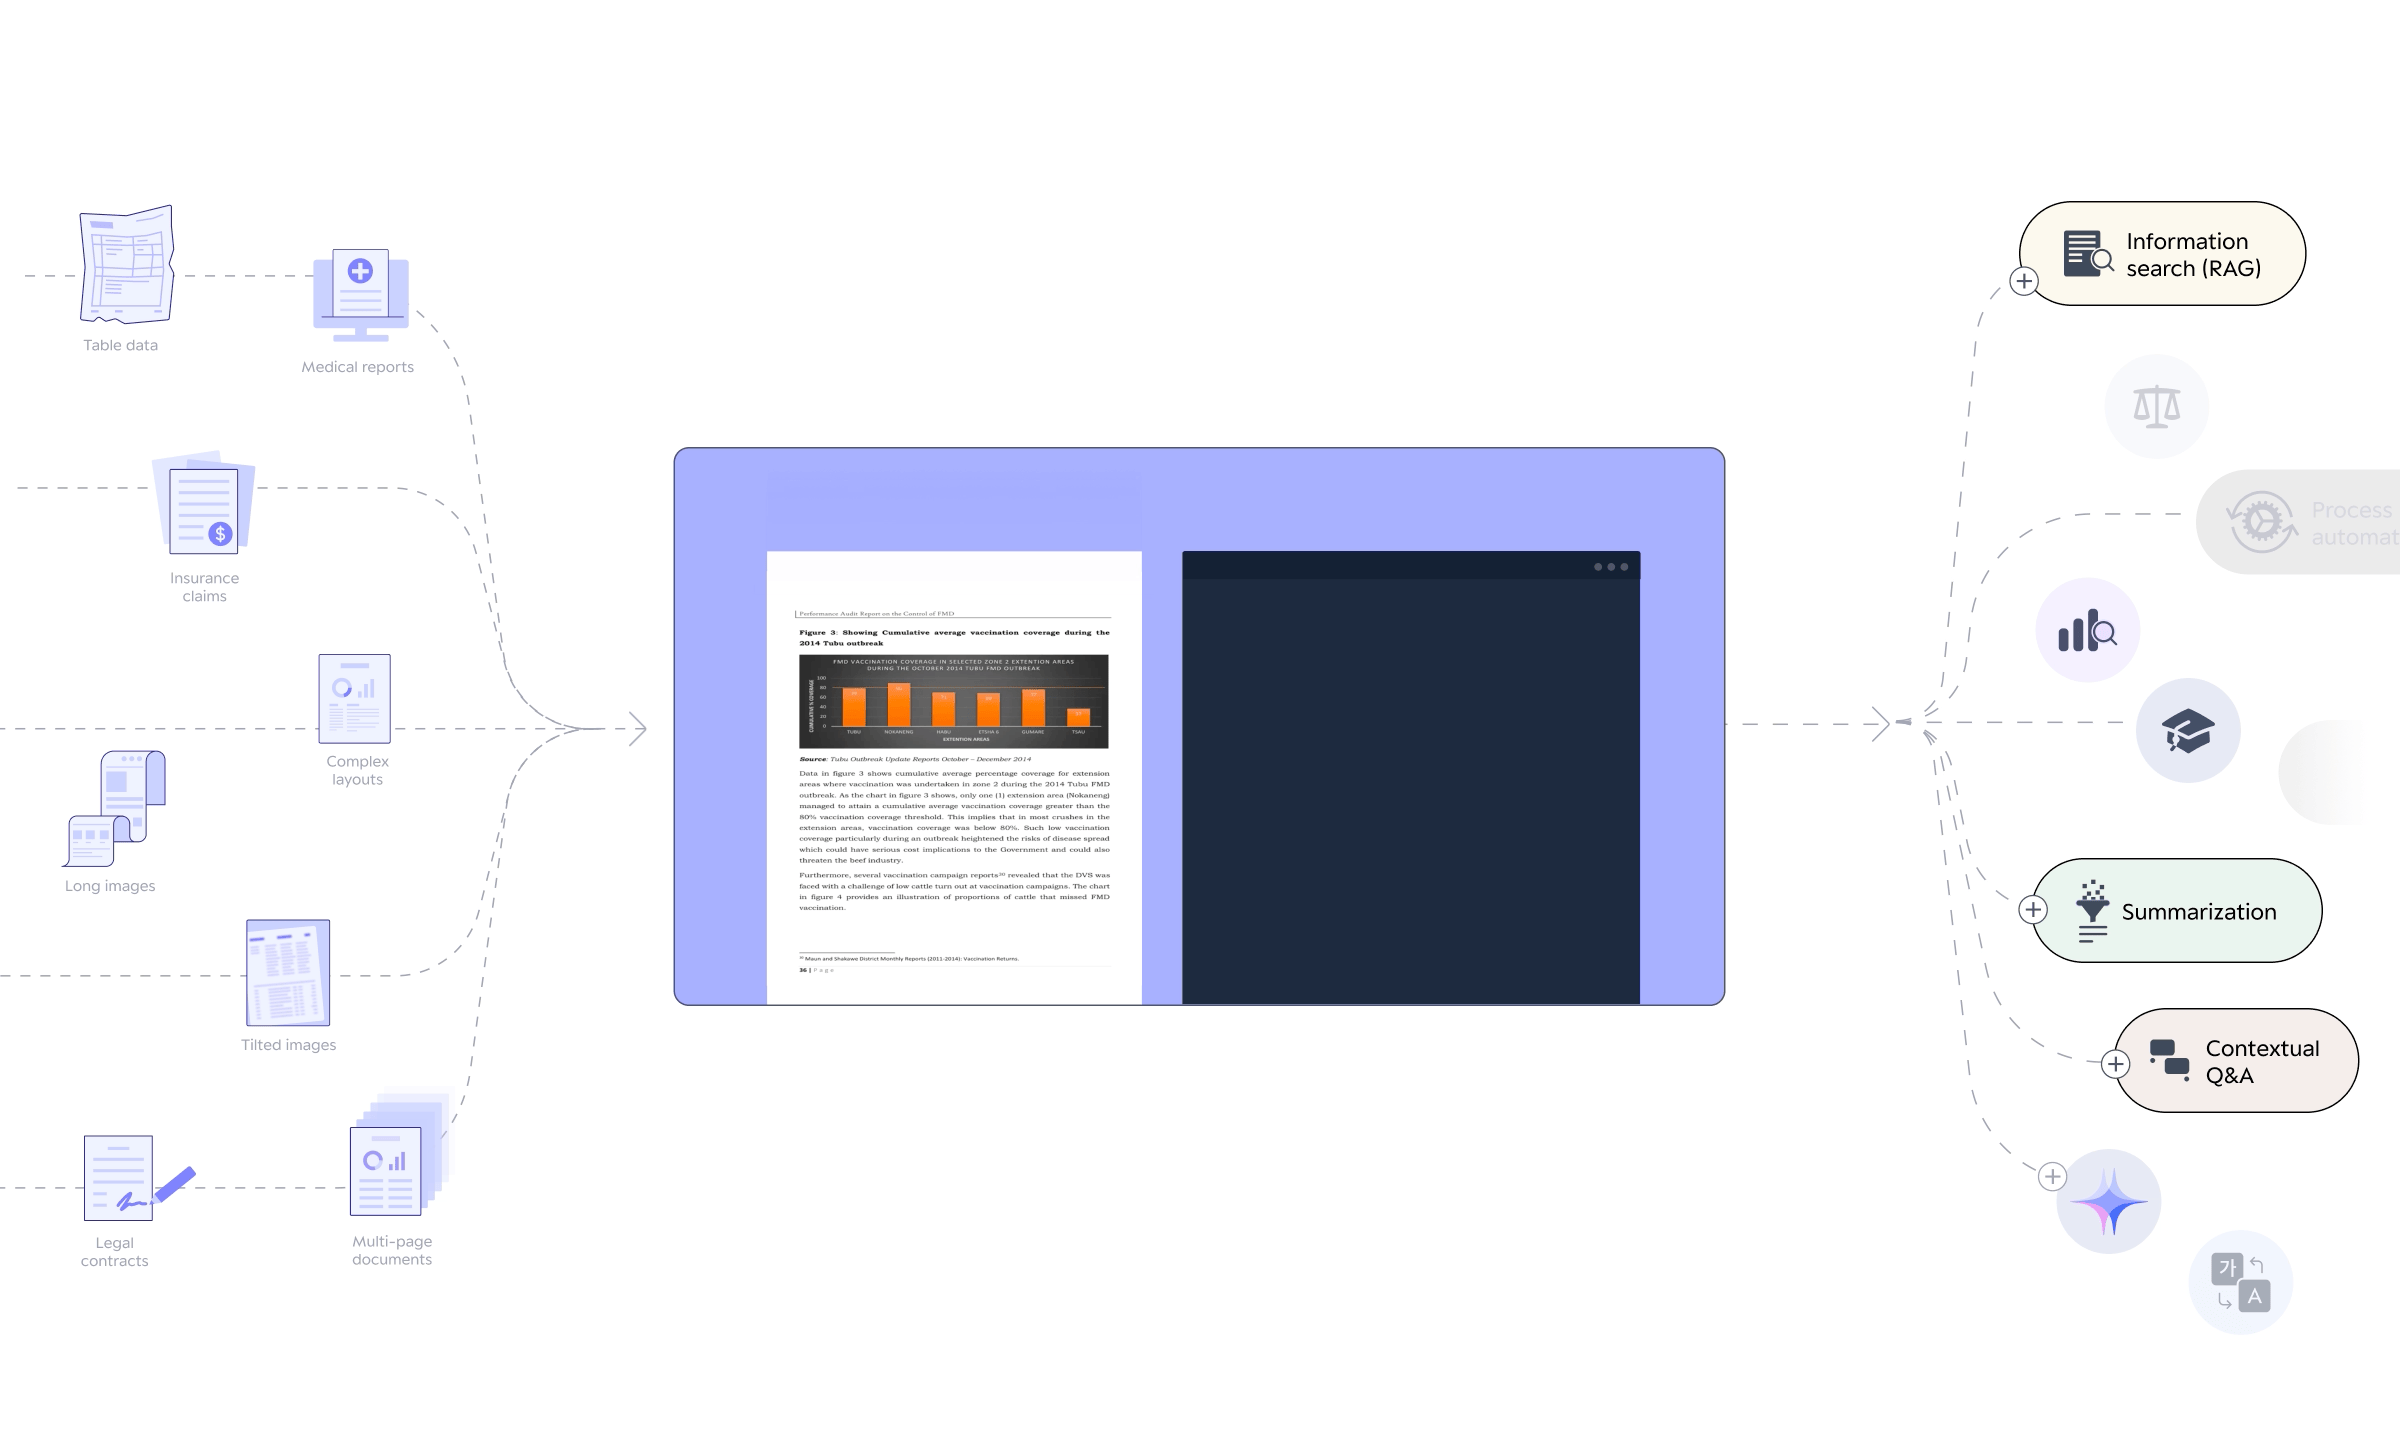
1. PDF나 스캔 이미지를 입력합니다. 복사가 가능한 본문인지, 이미지로만 된 페이지인지 먼저 확인합니다. 2. 본문과 표를 분석합니다. 문서 레이아웃 분석으로 요소를 구분하고, 좌표로 원본 페이지의 어느 위치에서 나온 내용인지 연결합니다. 3. 목적에 맞는 결과를 받습니다. 텍스트는 본문 가공에 활용합니다. 웹 문서 형식인 HTML은 표 구조를 표현하는 데 활용합니다. 간단한 기호로 제목과 문단을 표시하는 Markdown은 후속 문서 처리에 연결합니다.
금융 보고서 표 추출 결과를 엑셀이나 업무 데이터베이스에 넣으려면 별도 변환이 필요합니다. 열 이름, 금액 단위, 합계 일치 여부는 자체 규칙으로 확인합니다.
모드와 OCR 설정을 따로 고릅니다
standard는 텍스트와 단순 표, enhanced는 복잡한 표와 시각 요소를 다루는 모드입니다. auto는 페이지별로 처리 모드를 선택합니다. enhanced와 auto는 document-parse-260128 이후 지원되며, document-parse는 최신 안정 모델을 가리키는 별칭입니다.
스캔 문서의 OCR 설정인 auto·force는 처리 모드와 별도 옵션입니다. 여러 페이지에 걸친 표의 병합은 베타 기능이므로, 이를 쓸 때는 페이지 경계에서 행과 열이 제대로 이어졌는지 확인합니다.
Docling과 외부 AI API로 유사 기능을 구현합니다
공개된 기능과 비슷한 서비스를 개발한다면, Docling 또는 Azure Document Intelligence를 구현 대안으로 검토할 수 있습니다. 운영 환경과 필요한 출력에 맞춰 아래처럼 역할을 나눕니다.
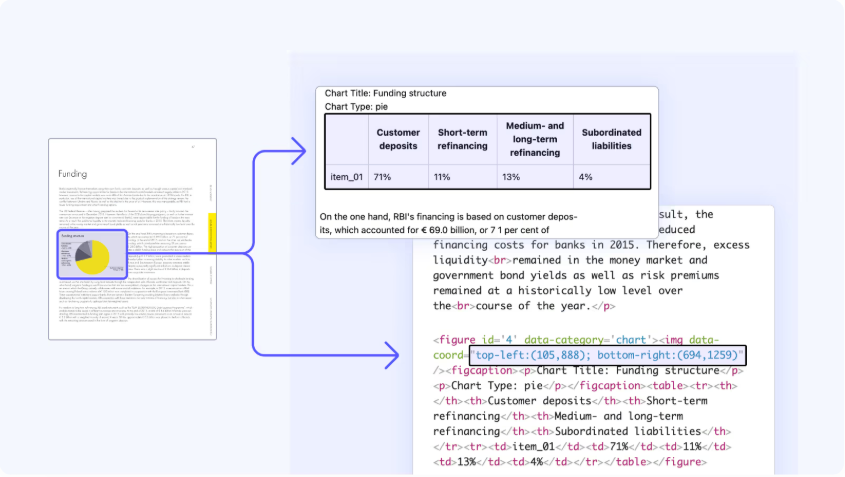
Docling 문서 파싱 구현에서는 오픈소스 문서 처리 라이브러리가 PDF·이미지의 OCR, 읽기 순서와 표 구조 분석을 담당합니다. 결과를 HTML·Markdown·JSON으로 내보내고 로컬에서 실행할 수 있습니다. 요소의 위치를 나타내는 경계 상자와 출처 정보는 제공 가능한 경우에 활용합니다.
Azure Document Intelligence는 문서를 보내 인식·분석 결과를 받는 클라우드 AI API 대안입니다. v4.0의 2024-11-30 정식 출시(GA) 버전 prebuilt-layout은 문자·표·구조와 Markdown 출력을 지원합니다. 이 버전은 Markdown 안의 표를 HTML로 표현하며, XLSX 표 분석과 Office 내장 이미지 처리에는 제한이 있습니다.
검증과 RAG 연결은 자체 로직으로 완성합니다
일반 API와 소프트웨어 개발 도구 모음인 SDK는 파일 전달과 결과 연동을 맡는 수단입니다. 결과가 정해진 데이터 구조에 맞는지 확인하는 스키마 검증과 좌표 기준 통일은 애플리케이션에서 구현합니다. 오류 재시도, 접근 권한과 사용자 검수 절차도 별도로 설계합니다. AI 스킬은 작업 지침과 도구 조율에 사용하고, 문자 인식은 선택한 엔진에 맡깁니다.
문서 파싱은 RAG 문서 전처리의 출발점입니다. RAG는 외부 자료를 검색해 답변에 활용하는 방식입니다. 파싱 이후에는 내용을 나누는 청킹, 검색용 수치 표현을 만드는 임베딩, 검색과 답변 생성이 이어집니다. 이 후속 단계까지 연결해야 사용자가 문서를 검색하고 근거를 바탕으로 답변을 받는 흐름을 만들 수 있습니다.
지원 범위를 확인하고 대표 문서부터 적용합니다
2025년 3월 업스테이지 공식 소개에는 API·AWS 배포·사내 인프라에 설치하는 온프레미스 옵션이 제시됐습니다. 당시 소개된 배포 방식의 현재 제공 범위는 제품 버전과 지역에 맞춰 확인해야 합니다. 도입할 문서의 이용 권한과 데이터 처리 조건도 함께 확인합니다.
먼저 실제 업무의 대표 PDF로 본문 순서, 표 구조, 좌표와 출력 형식을 확인해 문서 파싱 서비스 개발의 기준을 정합니다. 트램스 AI에 유사 기능 제작을 문의하려면 문서 유형과 원하는 출력, 연결할 업무를 함께 알려 주세요: https://trams.co.kr/ai-si/contact/#inquiry
참고 자료
- https://www.upstage.ai/products/document-parse
- https://console.upstage.ai/api/parse/document-parsing
- https://www.upstage.ai/blog/ko/introduce-upstage-document-parse
- https://blog.hancom.com/document-parsing-multi-format-rag-preprocessing/
- https://docling-project.github.io/docling/
- https://docling-project.github.io/docling/concepts/docling_document/
- https://learn.microsoft.com/en-us/azure/ai-services/document-intelligence/prebuilt/layout?view=doc-intel-4.0.0
비슷한 AI 서비스를
사업에 적용하고 싶으신가요?
아이디어와 필요한 기능을 알려주시면 제작 범위와 방법을 검토합니다.